引言
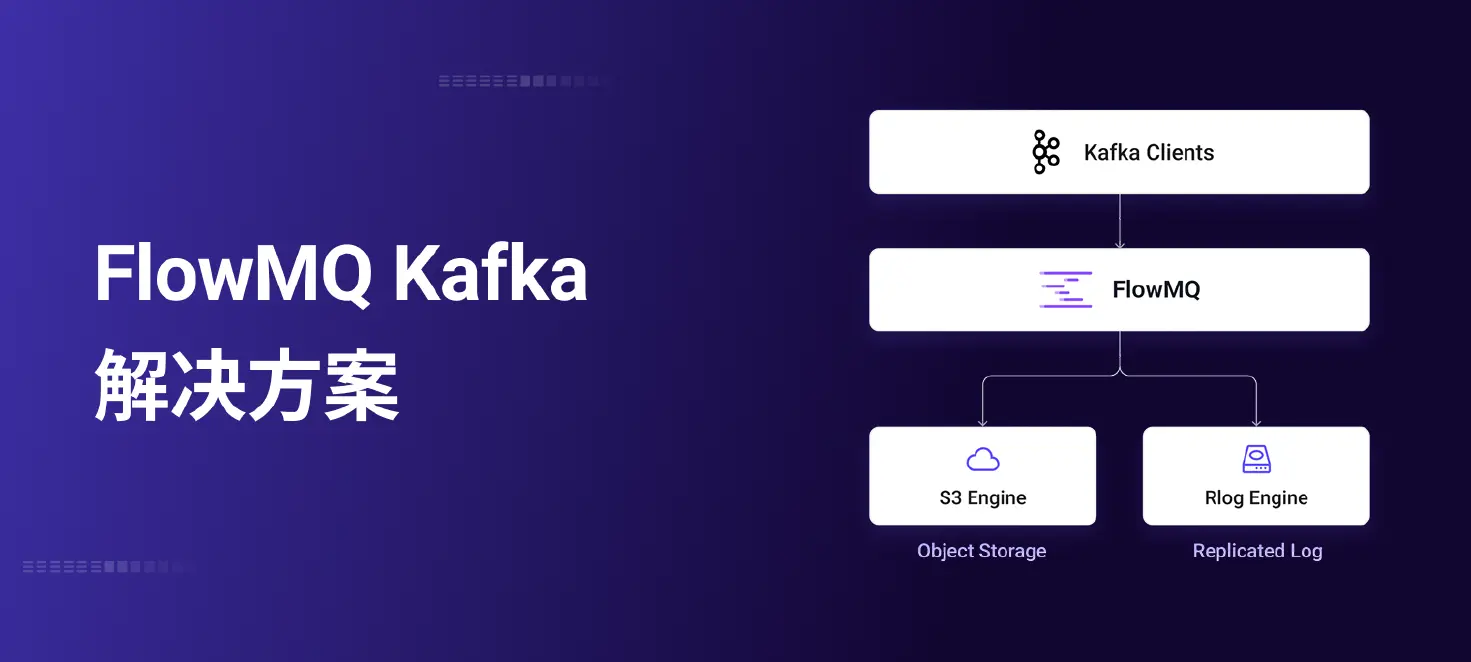
FlowMQ 是基于 C++ 从零构建的统一消息系统,面向发布/订阅、队列与流处理三种消息范式,支持 MQTT、Kafka、AMQP 和 NATS 等消息协议。
本文重点介绍 FlowMQ 的 Kafka 协议实现。FlowMQ 不仅兼容标准 Kafka 协议,还提供更优的架构与解决方案。目前支持 S3 和 RLog 两种存储后端,分别面向云环境的低成本存储和本地场景的低延迟存储。
Apache Kafka 面临的问题
随着 Kafka 承载的数据量和业务吞吐持续增长,团队不仅需要应对容量与性能压力,还要控制存储和运维成本。尤其在数据规模较大的场景下,传统存储架构在成本控制、集群扩容和资源利用方面逐渐显现出局限。
- 计算与存储紧密耦合:在 Apache Kafka 的本地日志架构中,Partition 是有序流数据的存储单元,其副本分布在指定的 Broker 上。Broker 既负责处理请求,也承担对应副本的日志存储,使计算资源、磁盘容量和数据副本位置紧密绑定。
- 存储与网络成本持续增长:Kafka 通过多副本保障数据可靠性,但每个副本都需要占用独立的块存储空间。在多 AZ 部署中,副本间的日志复制还会产生跨可用区网络流量。随着数据吞吐和保留时间增加,存储与网络成本也随之攀升。
- 扩容伴随数据迁移:新增 Broker 并不会自动分担已有 Partition 的数据负载。团队通常需要通过 Partition Reassignment,将现有副本迁移到新节点。迁移期间,数据复制会与在线读写争用磁盘和网络资源;数据规模越大,迁移耗时和对业务的潜在影响也越明显。
- 容量与负载难以均衡:由于每个副本受所在 Broker 的磁盘容量约束,大 Partition 容易造成节点间资源分布不均。即使集群整体仍有可用容量,个别节点也可能率先遭遇磁盘空间或网络带宽瓶颈,限制集群的实际承载能力。
因此,Kafka 扩容不仅意味着增加计算和存储资源,还涉及副本重新分配、数据迁移及持续的运维管理。随着业务规模扩大,数据搬迁和资源规划会反复发生,进一步增加系统扩展的复杂度与总体成本。
FlowMQ Kafka 解决方案
方案架构
FlowMQ Kafka 采用计算存储分离的架构。Kafka 协议层支持标准 Kafka 协议,兼容各种 Kafka 客户端与 Topic、Partition、Consumer Group、认证、保留策略等标准功能,现有业务无障碍迁移。存储层由 S3 或 RLog 承载数据。计算和存储层可按需各自扩容。
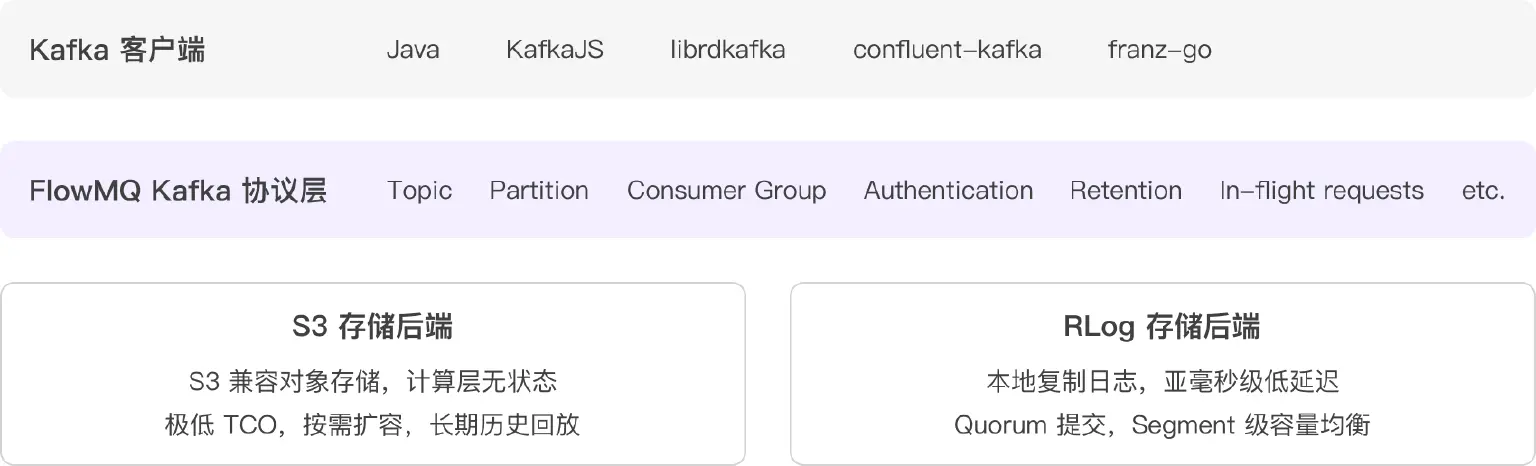
统一 Kafka 协议层与 S3、RLog 双存储后端
FlowMQ Kafka-S3:云上极低成本部署
FlowMQ Kafka S3 后端以 S3 兼容对象存储承载数据,其能够实现极低云上成本部署的关键因素如下:
- 在相同的存储量下,对象存储服务相较于自部署的多副本 Kafka 存储有明显的价格优势。
- 对象存储服务按使用量计费,而自部署 Kafka 必须提前分配高规格存储容量。
- 在跨 AZ 部署中,FlowMQ 直接读写对象存储服务,因此也直接避免了昂贵的跨 AZ 数据复制成本。
以 AWS、1 GB/s 吞吐、多 AZ 部署的月度基础设施成本为例,Apache Kafka 为 286,636 美元/月,FlowMQ S3 为 18,138 美元/月。读者可自行比较按目标存储和吞吐在不同的云提供商上计算部署成本。
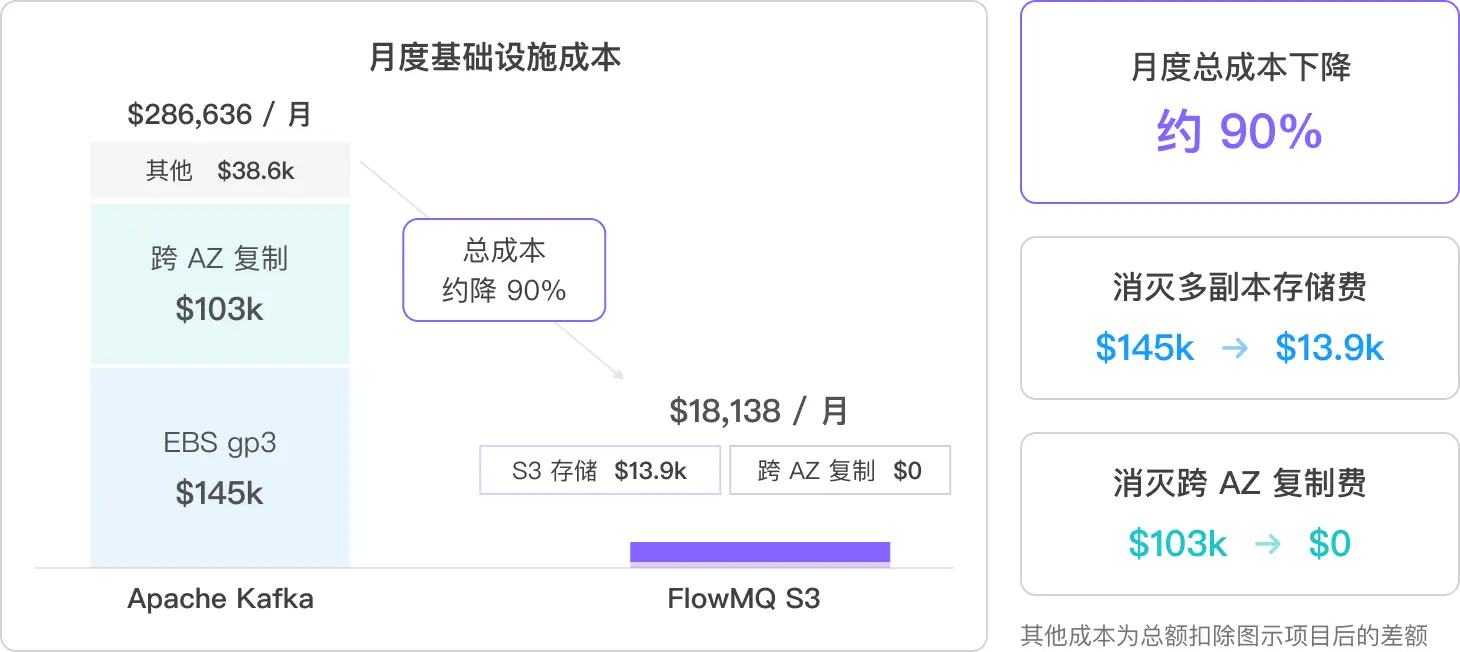
AWS、1 GB/s、多 AZ 场景的月度基础设施成本示例
与此同时,FlowMQ Kafka S3 计算层完全无状态,扩容/缩容只需要加入/减少计算节点,按业务需求调整计算资源,而不需要像自部署 Apache Kafka 集群一样提前计算与分配高规格计算存储节点。
FlowMQ Kafka-Rlog:低延迟本地存储
对于需要本地私有化部署或对数据访问延迟有更高要求的场景,FlowMQ 提供 RLog 存储后端。
RLog 是 FlowMQ 自主研发的分布式 Log 存储引擎,其设计基于流数据的两个特点:
- 数据写入方向始终向后。
- 历史数据一旦写入便不再修改。
因此,RLog 将一个 Partition 的日志按序划分为多个 Segments,包含 0 个或者多个已封存的只读 Segments 和一个活跃 Segment,以每个 Segment 为粒度配置复制组。这样,历史数据副本可以更细粒度地分散到不同节点,容量均衡不必始终围绕整个 Partition 副本进行。
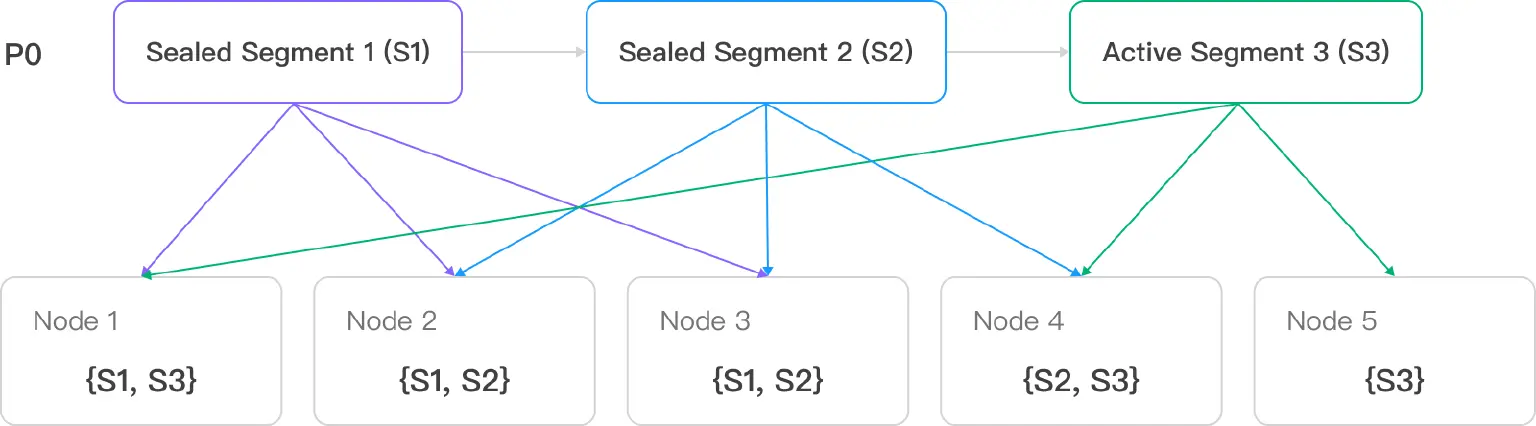
一个 Partition 的 Segment 副本分布示例
(上图中,S3 为活跃 Segment,每个 Segment 均有三个副本,S1 存储于 1、2、3 节点,S2 位于 Node 2、3、4 节点,S3 位于 Node 1、4、5 节点。)
这种设计相比于 Apache Kafka 有如下优势:
- 复制组存储粒度更小,可以更均匀分配在不同的节点里
- 工作负载动态实时调整,而不是总聚集在固定的节点上
- 当新节点加入集群时,新 Segment 自动扩容到新节点,而无需手动 Reassignment 与数据复制
- 当故障发生时,马上封存当前活跃 Segment ,切换到新 Segment ,复制协议简化,故障恢复速度快
Flexible Quorum:灵活的副本配置与故障恢复
RLog 复制协议采用 Flexible Quorum 1,设副本总数为 N、最小写入副本为 W、最小恢复副本为 R,当满足复制组 W + R > N 时,可保证强一致性,而不需要多数派。
以两 AZ、跨 AZ 部署的场景为例,对比 Apache Kafka (ISR)、Redpanda (Raft)、FlowMQ Kafka-RLog 的部署和故障恢复能力。
- Apache Kafka (ISR):在四副本、每个 AZ 两个副本的部署,且 acks=all、min.insync.replicas=3 的配置下,可以容忍一个节点故障;当整个 AZ 故障时,只剩两个副本,无法满足写入门槛。如果故障 AZ 无法及时恢复,且不降低门槛,通常需要运维或自动化平台补充节点、调整副本分配。新副本必须追赶历史日志并加入 ISR,才能补齐写入条件;历史数据量大时,这一步可能涉及大量数据拷贝,且长期无法恢复。2
- Redpanda (Raft):Redpanda 使用 Raft 进行 Partition 数据复制,写入提交和选主都依赖多数派。多数派往往是奇数副本数,在两 AZ 场景下,只要多的那个 AZ 故障,就会出现数据丢失且无法读写。而部署偶数副本数(如四副本),每个 AZ 两副本的部署下,多数派需要三个副本,失去一个 AZ 后仅剩两个,无法形成多数派。因此强一致读写服务及正常选主、成员变更恢复无法继续,单纯启用空白备用节点也不能绕过原复制组的多数派要求,陷入完全不可用的状态。Apache Kafka 的 Controller 也使用 Raft (KRaft) 作为复制协议,故也面临同样问题。
- FlowMQ Kafka (RLog):FlowMQ Kafka-RLog 采用 4-3-2 配置,即四副本、写入需三个副本确认、恢复只需两个副本参与。单 AZ 故障后,两个存活副本仍满足 R=2,故障切换后的读取与日志恢复逻辑可以正常运行。剩余两个副本不足 W=3,暂时无法写入,但启用备用节点/备用 AZ 后(可自动化),新数据会选用新节点作为复制组,集群马上自动恢复写入,而不必等待一次大规模历史数据搬迁。写入中断主要取决于故障切换与备用节点/备用 AZ 启用过程,全程数据强一致且故障恢复时间极短。
典型应用场景
FlowMQ Kafka 的 S3 和 RLog 两种存储后端面向不同的数据存储需求,可根据业务的数据规模、访问模式、部署环境和延迟要求灵活选择。
FlowMQ Kafka-S3:面向数据大规模写入与长期留存
适用于日志留存、用户行为埋点、IoT 设备数据上报、审计流水和监控指标等场景。这类业务通常具有持续写入、数据量大、保留周期长等特点,对单位存储成本、跨 AZ 流量成本和弹性扩缩容能力更为敏感。FlowMQ Kafka-S3 可通过对象存储降低长期数据保存成本,并支持计算节点按业务峰谷独立伸缩。
FlowMQ Kafka-RLog:面向低延迟与高可用业务
适用于金融交易、在线风控、实时订单、游戏消息、工业控制及私有化消息中台等场景。这类业务通常对读写延迟、服务可用性和故障恢复速度有更高要求,同时可能需要满足本地化部署需求。FlowMQ Kafka-RLog 通过细粒度 Segment 分布和 Flexible Quorum 复制机制,提升数据分布灵活性与故障恢复效率。
总结
随着业务规模和数据需求不断增长,消息系统需要在性能、成本与扩展性之间取得更好的平衡。FlowMQ Kafka 通过更灵活的架构设计与存储方案,为 Kafka 业务提供了新的技术选择,也为不同规模和部署需求下的业务增长提供了更大的灵活性。
两种存储后端的实际数据存储与扩容操作,已在此前的技术直播中进行演示。欢迎观看回放,了解更多技术细节。
参考资料:
[2] Apache Kafka: Replication 与 Availability and Durability Guarantees
[3] Redpanda: How Redpanda Works — Raft consensus algorithm